El poder de las CNN en el análisis de imágenes. Publicado originalmente en The Deep Hub.
Las redes neuronales convolucionales, o CNN, son redes especializadas en procesar y clasificar imágenes.
Pero ¿cómo se clasifica una imagen? Las imágenes también son números: una imagen digital es una cuadrícula de píxeles y cada píxel guarda color e intensidad.
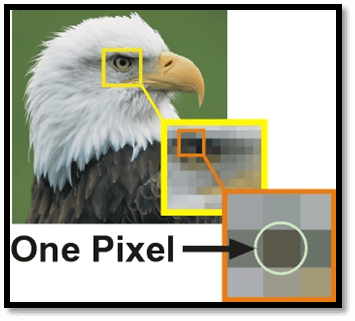 Representación de píxel | Fuente
En color, un píxel suele tener tres valores correspondientes a rojo, verde y azul (RGB). En escala de grises, contiene un único valor de intensidad, normalmente entre negro (0) y blanco (255).
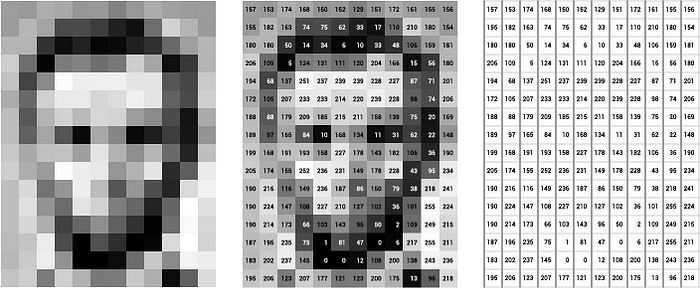 Imagen en escala de grises | Fuente
¿Cómo funcionan las CNN?
Primero, recordemos una red neuronal básica:
- Neuronas: unidades que combinan funciones lineales y una función de activación no lineal.
- Capa de entrada: cada neurona representa una característica de entrada. Una imagen de 28 × 28 tendría 784 entradas, una por píxel.
- Capas ocultas: transforman la salida de la capa anterior.
- Capa de salida: tiene tantas neuronas como clases; para regresión suele tener una.
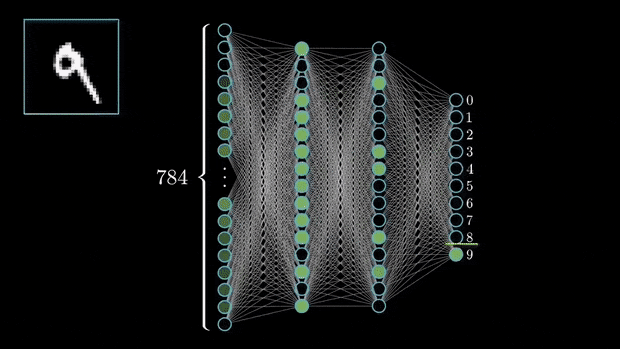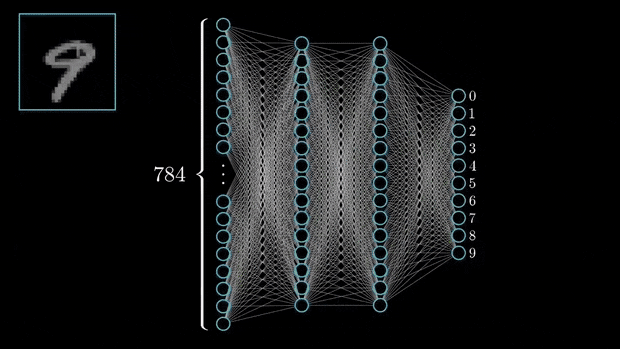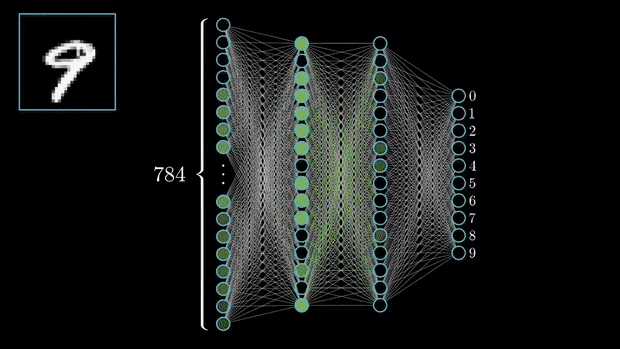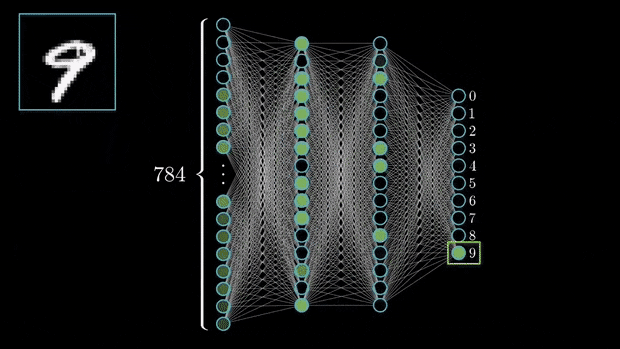 Proceso de red neuronal | Fuente: 3Blue1Brown
Tras predecir, calculamos una pérdida y ajustamos los pesos mediante backpropagation.
La diferencia central de una CNN está en sus capas especializadas.
Capas convolucionales
Son los bloques fundamentales de una CNN. Aplican convoluciones mediante filtros llamados kernels, pequeñas matrices que recorren la imagen y aprenden patrones visuales complejos.
Un kernel multiplica sus valores por los píxeles que cubre y suma el resultado. Así extrae bordes, texturas y formas.
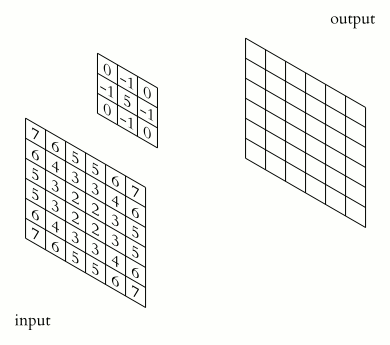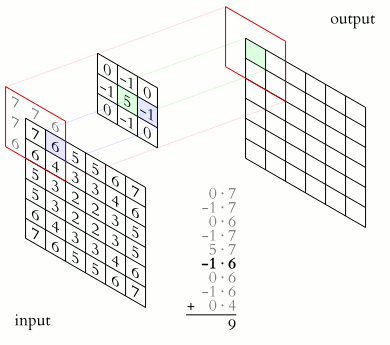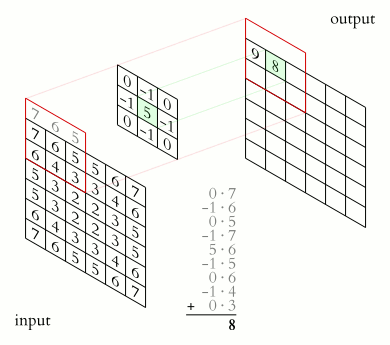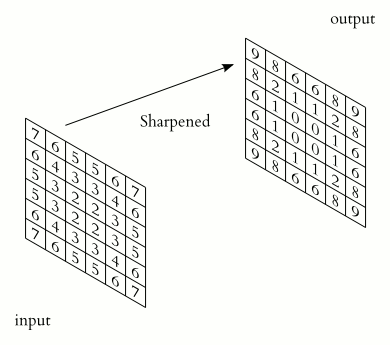 Operación de kernel | Fuente
Con un kernel 2 × 2, cada posición de la imagen produce un valor. El conjunto de valores de salida se llama mapa de características (feature map).
Para entender una capa convolucional hay tres conceptos esenciales: canales, stride y padding.
1. Canales
Las imágenes RGB tienen tres canales, cada uno una matriz. Una capa convolucional tiene también canales: cada filtro genera un mapa de características distinto y el conjunto de mapas forma su salida.
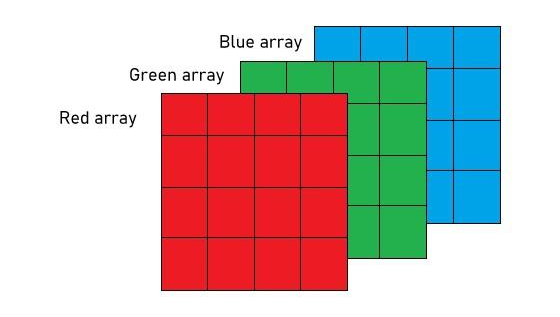 Imagen RGB descompuesta | Fuente
La profundidad de una capa es el número de kernels. Cada canal puede especializarse en detectar una característica, como orejas o boca de un gato.
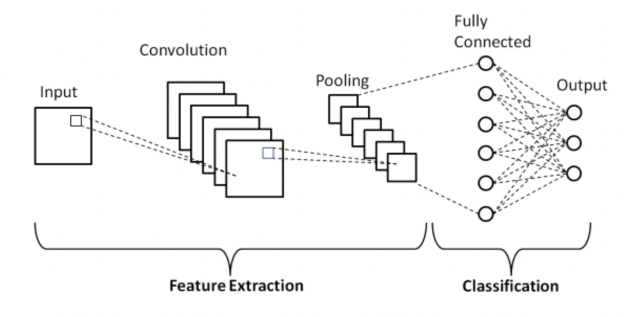 Representación de CNN | Fuente
No confundas los canales de color de la imagen con los canales de una capa convolucional: podemos añadir tantos filtros como necesitemos y cada uno aprende una característica diferente.
2. Stride
El stride indica cuántos píxeles avanza el kernel cada vez.
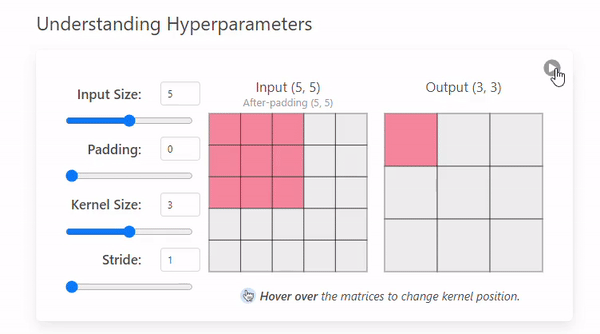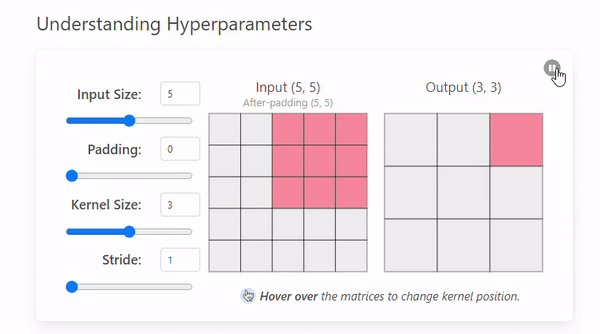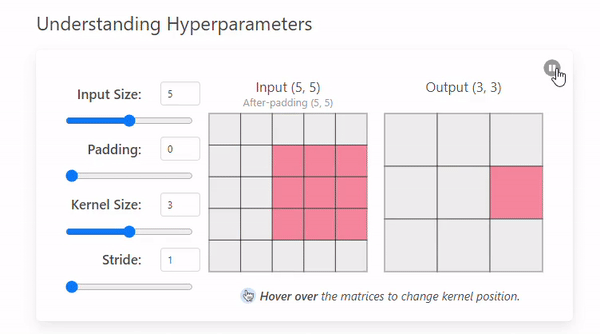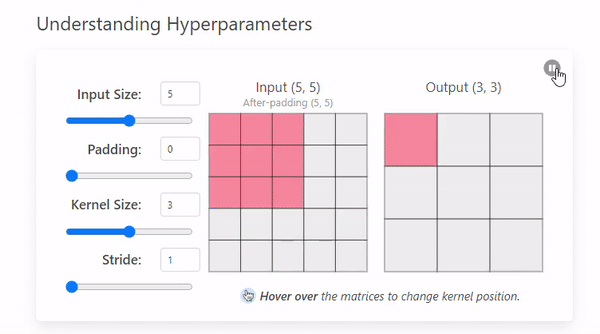 Stride 1 | Fuente
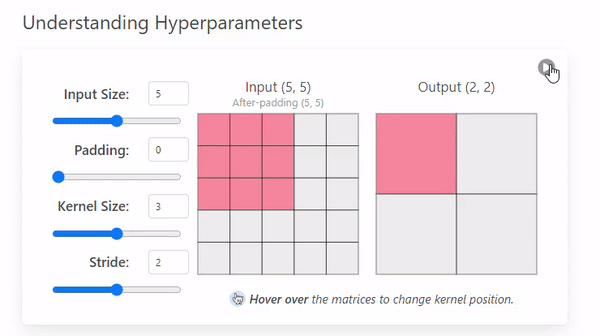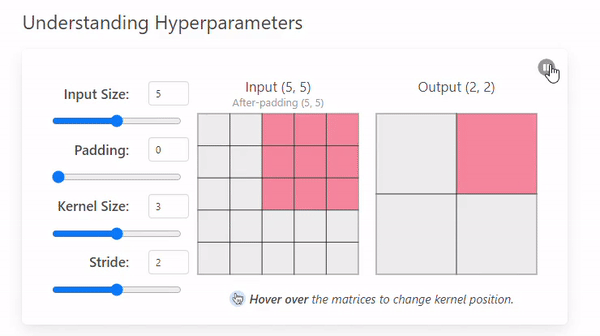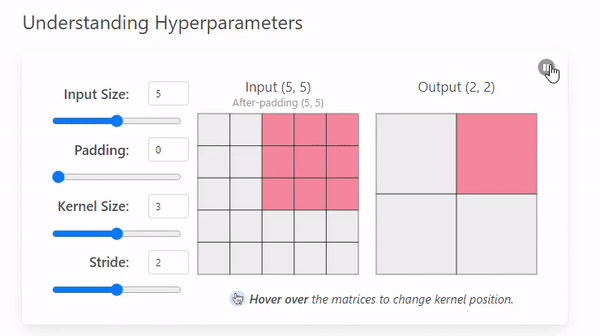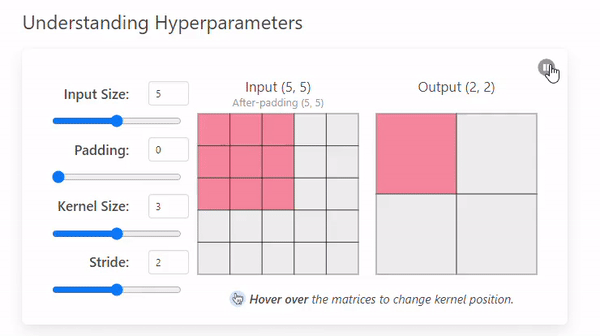 Stride 2 | Fuente
Un stride mayor produce una salida espacialmente más pequeña porque recorre la imagen más rápido. Puede capturar rasgos más globales, reducir cálculo y ayudar a controlar el sobreajuste. Uno menor conserva detalles más finos y locales.
3. Padding
El padding añade píxeles alrededor de los bordes. Sin él, los píxeles de las esquinas se recorren menos que los centrales.
 Padding 0 | Fuente
 Padding 1 | Fuente
Padding preserva información espacial de los bordes y aumenta el tamaño del mapa de características de salida. Conviene usarlo cuando los bordes contienen información importante.
La salida se calcula mediante:
El término 2 × padding representa los lados opuestos de la imagen, y +1 la posición inicial del filtro. El padding puede ser asimétrico y personalizado.
Las capas convolucionales extraen características; no son por sí solas una CNN completa. También necesitamos pooling y flattening.
Capas de pooling
Aunque una convolución puede reducir el tamaño espacial, su objetivo principal es extraer características, no reducir dimensionalidad.
Pooling sí busca reducir el tamaño de cada mapa de características, conservando información importante mediante el máximo o el promedio de cada ventana.
 Max y Average Pooling | Fuente
En el ejemplo se pasa de 4 × 4 a 2 × 2.
A diferencia de la convolución, pooling no aprende un kernel: simplifica los datos con una operación matemática.
Pooling no reduce el número de canales. Se aplica de forma independiente a cada canal; solo reduce las dimensiones espaciales.
 Capas dentro de una CNN | Fuente
Capas de flattening
Flattening reorganiza todo un mapa de características multidimensional en un vector largo.
 Concepto de flattening | Fuente
No modifica la información, solo cambia su forma.
Sirve para:
- Integrar características: permite combinar rasgos extraídos de distintas posiciones para tareas como clasificación.
- Conectar con capas densas: las capas totalmente conectadas operan sobre datos unidimensionales.
Las capas convolucionales detectan rasgos; las densas los integran para producir predicciones. En reconocimiento facial, las primeras detectan bordes y texturas; las densas pueden combinarlos para reconocer rasgos de un rostro.
Resumen de una CNN
La estructura reúne:
- Capas convolucionales.
- Capas de pooling.
- Capas de flattening.
- Capas densas.
También necesita funciones de activación y backpropagation.
Funciones de activación
Sin activaciones, la red sería un modelo lineal enorme.
En la parte de extracción, las activaciones se aplican tras las capas convolucionales. Pooling y flattening no necesitan activación: el primero reduce dimensionalidad y el segundo reorganiza datos.
Representación completa de CNN | Fuente
Las capas densas y la capa de salida sí usan activaciones para aprender interacciones complejas y hacer clasificaciones o predicciones.
Activaciones en capas convolucionales y densas
ReLU devuelve la entrada si es positiva y cero si no. Reduce tiempo de entrenamiento y mitiga el problema de gradiente que se desvanece.
Leaky ReLU permite un gradiente pequeño, pero no nulo, cuando la unidad está inactiva, lo que ayuda a evitar neuronas muertas.
Activaciones de salida
Sigmoid devuelve valores entre 0 y 1. Ya no es habitual en capas ocultas por el gradiente que se desvanece, pero sigue siendo útil para clasificación binaria.
Tanh devuelve valores entre -1 y 1 y puede funcionar mejor en algunos problemas por su rango de salida.
Bibliografía
- CNN Explainer
- IBM: Convolutional Neural Networks
- Guía completa de CNN
- CNN for Visual Recognition
- CNNs explained
¡Gracias por leer! Si te ha gustado el artículo, puedes dejar hasta 50 aplausos y seguirme en Medium para estar al día de los próximos artículos.